 新型数字基础设施“源启”
 分布式核心系统
 分布式金融PaaS平台
 数据中台
 数字化营销
 风险及合规
 支付结算
 渠道解决方案
 信贷管理
 交易银行
 开放银行
 数字化运营
 质量安全管理平台
 人工智能应用
 行业解决方案
源启·知数平台:为金融大模型“供料”,让非结构化知识真正“活”起来
在金融机构里,文档、报告、合同、公告……体量庞大,散布于各个业务系统。它们承载着业务智慧,却长期沉睡在文件夹和共享盘里——检索靠关键词,分析靠人工翻阅,复用更是无从谈起。
大模型来了,但金融行业很快发现:模型再强,也“吃”不下散落在扫描件、PDF、邮件里的非结构化知识。传统知识库做的是“存、搜、看”,本质是静态仓库,无法为大模型提供可理解的原料。要从“存、搜、看”升级为“可理解”,关键不在于存得更多,而在于建一条把原始文档加工为认知型知识的生产线。
源启·知数平台的出现,让知识管理第一次拥有了“工业化加工中枢”的能力,将分散的文档加工为“认知型数据资产”,并封装为API与MCP服务,支撑上层智能应用。知识,从此不再是“被检索”,而是“被理解、被推理、被复用”,真正成为大模型可信赖的“原材料”。
创新一:从“知识库”到“知识中台”,跨越本质鸿沟
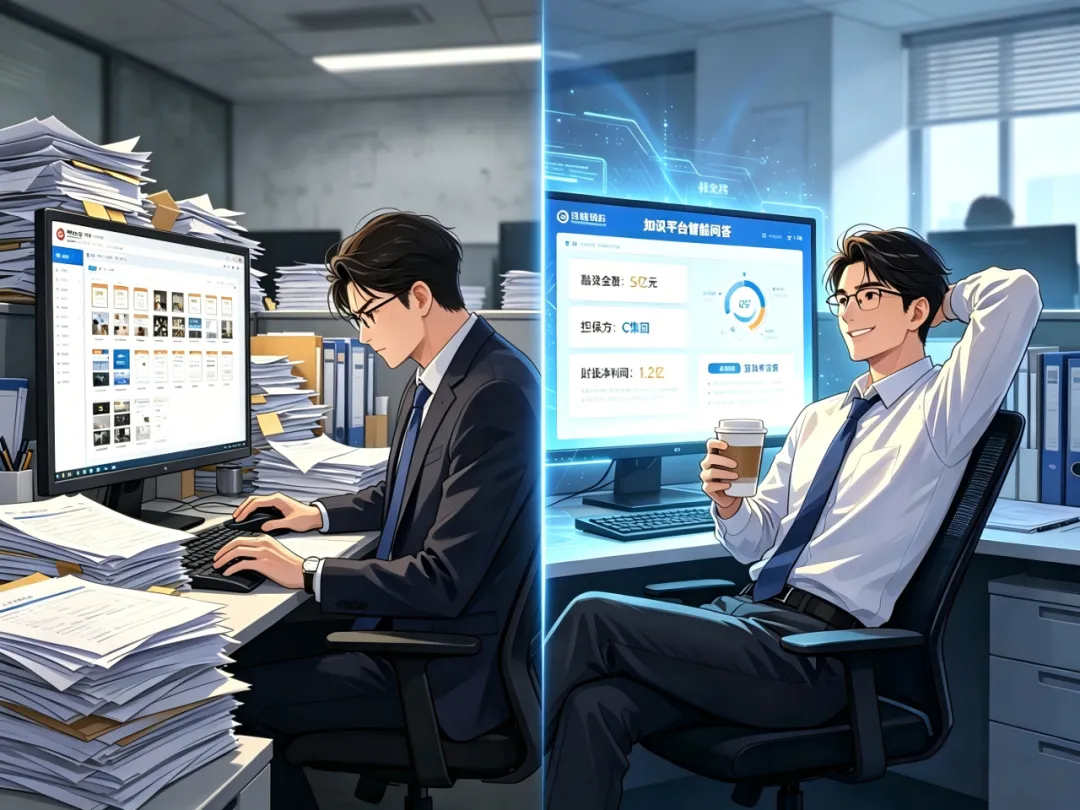
知数平台定位于企业级知识中台,而非单一应用的知识库。它提供可复用的知识生产流水线、可共享的认知资产、可治理的知识服务体系——一次加工,多处复用,支撑前台各类智能应用。与传统RAG仅做向量相似度召回不同,知数平台实现向量+图谱+标签多路召回,并具备图谱推理能力,让知识从“被检索”升级为“被理解、被推理、被复用”。
创新二:三类工业化流水线,让知识生产标准化
将“文档→知识”的加工过程标准化为三类流水线——解析与结构化、知识资产构建、知识服务化。支持模板、流水线实例、任务、任务实例的分层管理,实现知识生产的工业化,告别手工作坊式加工。
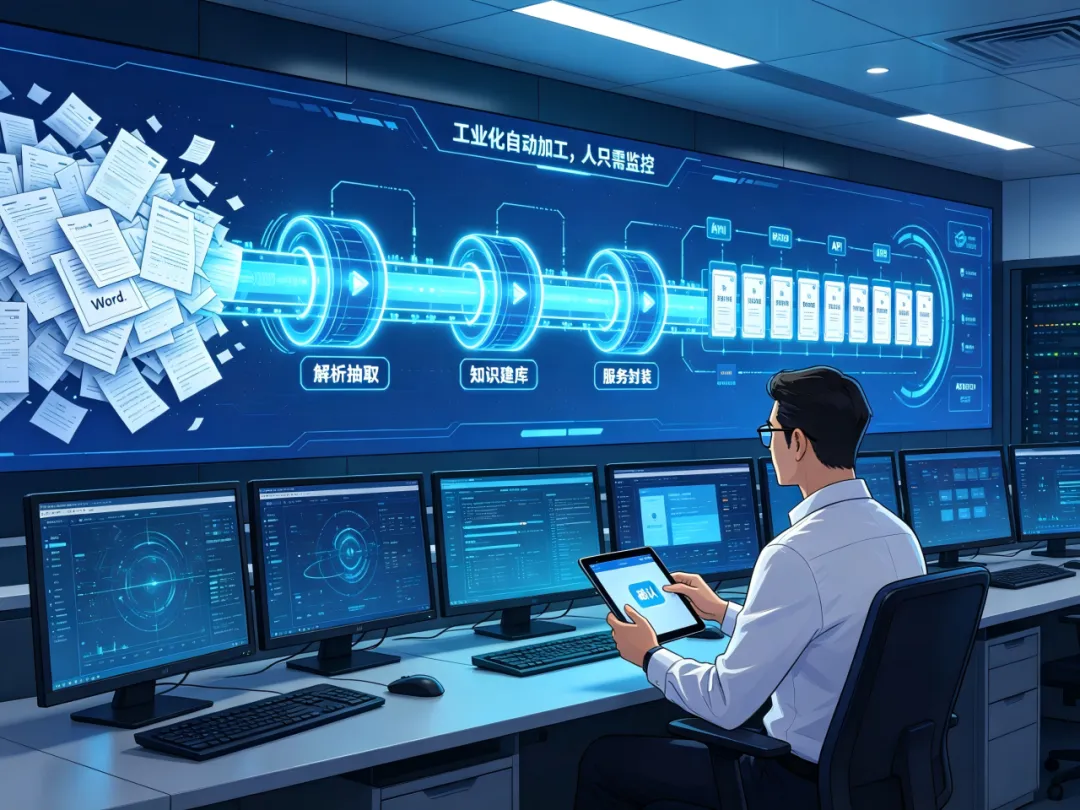
同时,知数平台支持30+种数据源类型(FTP、HDFS、数据库、Kafka、API等)统一接入,无论是扫描件、表格、多版式文档,还是结构化数据,都能顺畅进入加工链路。
创新三:标准摘要向量 + 知识图谱,让知识“可理解、可推理”
传统“摘要”是对一篇文章做概括,而知数平台的“标准摘要”是按业务模板抽取原子化事实单元,如“融资金额5亿元”“担保方C集团”。它不是一段通顺的文章,而是一条条可查询的精准事实,支撑精准问答——针对事实性问题,标准摘要向量库的问答命中率可达85%~90%。
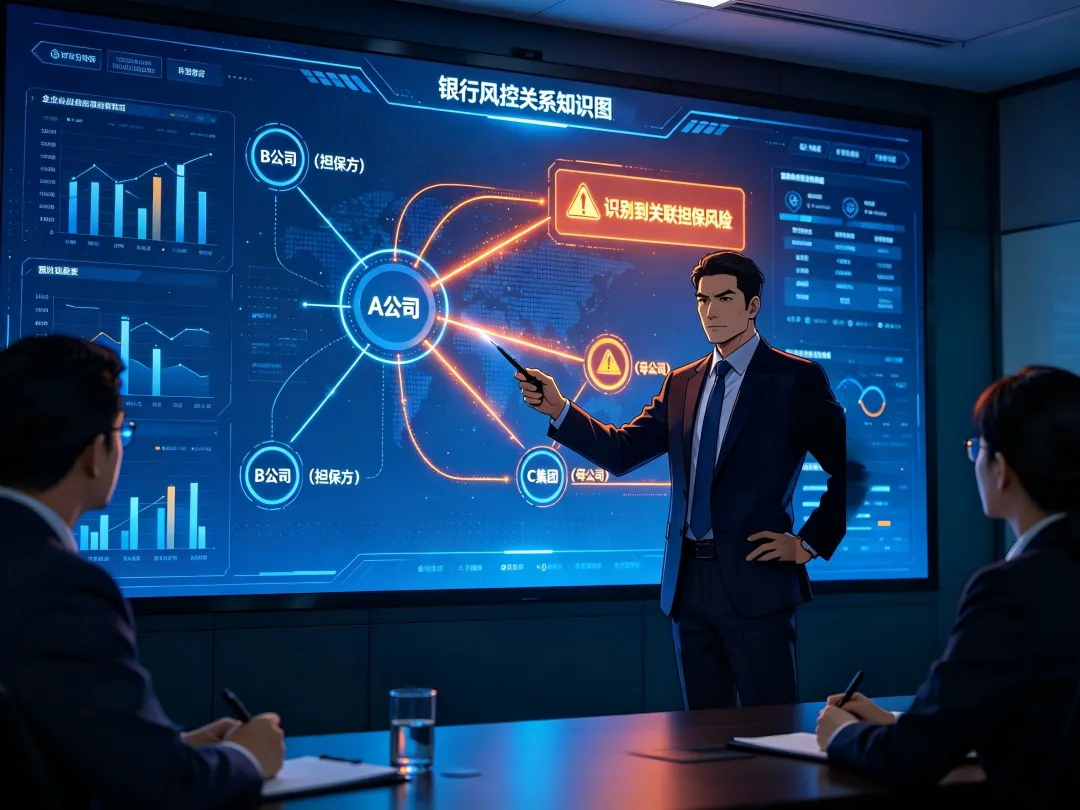
更进一步的,是本体驱动的知识图谱。系统从文本中抽取实体与关系,结合本体建模(骨架层、对齐层、思维层),实现业务语义层的可计算、可推理。例如,系统能基于本体规则与图谱关系,自动识别“担保方是融资方的母公司”,发现“关联担保”风险点,让风控从“人工排查”升级为“系统主动预警”。
除此之外,知数平台能够实现结构化数据与非结构化文档的统一建模与统一服务,支持DWD层(流水表)、DWS层(维度表)、ADS层(实时数据)的数仓数据统一接入,与文档解析结果融合加工,让主数据与文本知识共同构成完整的业务认知。在此基础上,平台将单一资产能力封装为原子服务(向量检索、图谱查询、标签查询),并通过DAG(有向无环图,一种将多个原子服务按依赖关系串联为工作流的技术编排方式) 跨资产调用形成组合服务,灵活支撑“企业全息画像”等复杂场景;同时解析库与知识库支持跨项目授权引用,实现“一处构建、多处复用”,让新场景应用开发周期从“周”级缩短至“天”级,避免重复建设,节省50%以上投入。
在典型场景中,知数平台已为金融机构带来切实价值:
提升非结构化数据治理效率:对于规范格式的文档,接入与预处理效率提升70%以上;行业实践方面,某集团财务公司已落地企业征信报告识别+风险挖掘预警;某股份制银行完成知识中台+门户建设,实现全行知识资产统一复用。
当AI进入知识管理领域,改变的不只是检索效率,而是金融机构对“数据资产”与“业务决策”的理解方式。源启·知数平台,让沉睡的文档资产,变成可计算、可推理、可复用的竞争优势。
注:文章配图由AI生成