 新型数字基础设施“源启”
 分布式核心系统
 分布式金融PaaS平台
 数据中台
 数字化营销
 风险及合规
 支付结算
 渠道解决方案
 信贷管理
 交易银行
 开放银行
 数字化运营
 质量安全管理平台
 人工智能应用
 行业解决方案
源启ChatBI焕新发布:5秒极速响应,LLM调用量直降90%
数智化转型纵深推进,企业数据体量持续膨胀,ChatBI(智能问数)成为释放数据价值的核心抓手。但不少企业落地AI数据分析后,普遍陷入“好看不好用”的困境:
❌ 回答慢:一个问题等十几秒甚至更久
❌ 经常答错:理解偏差导致SQL错误
❌ 成本高:LLM调用频繁,成本居高不下
❌ 无法生产使用:Demo很炫,上线后问题频出
针对这一行业共性痛点,中电金信经过多轮技术打磨与客户场景验证,焕新升级源启智能问数软件(源启ChatBI)。这款产品以架构级重构实现速度、精度、成本三重突破,将AI问数升级为真正可规模化落地的企业级生产力工具。
三大核心指标,定义企业级问数新标准
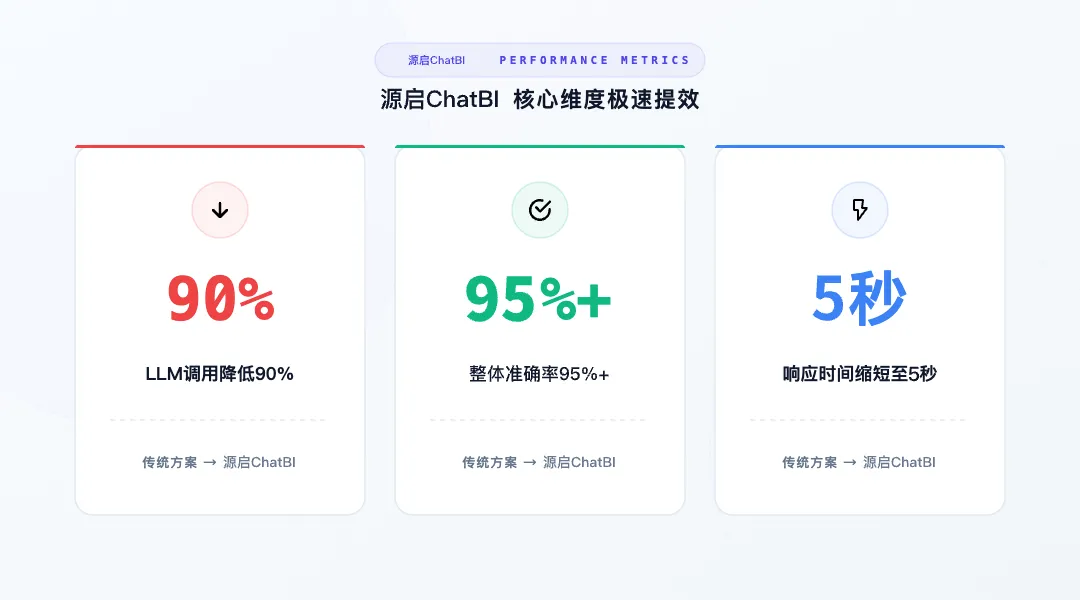
区别于行业主流的传统推理方案,源启ChatBI以全新技术路径交出三项硬核表现:
更快:5秒内完成全流程分析。
• 传统智能问数(Agent Loop方案):单次查询耗时12~18秒;
• 源启ChatBI(Skill Pipeline):5秒以内。
更准:综合准确率超95%。
• 结果可追溯:全链路操作留痕,从自然语言解析到SQL生成每一步都有据可查;
• 支持人工确认(HITL):绝不盲目猜测输出,保障结果可靠可用。
更省:LLM调用量降低90%。
• 传统方案单次查询需调用大模型8~11次,源启ChatBI将单轮查询的大模型调用压缩至0~2次;
• 叠加四层分级缓存体系,80%高频常见问题直接命中缓存、零模型调用,整体使用成本降低70%以上。
五层技术架构、六大技术创新,筑牢生产级能力底座
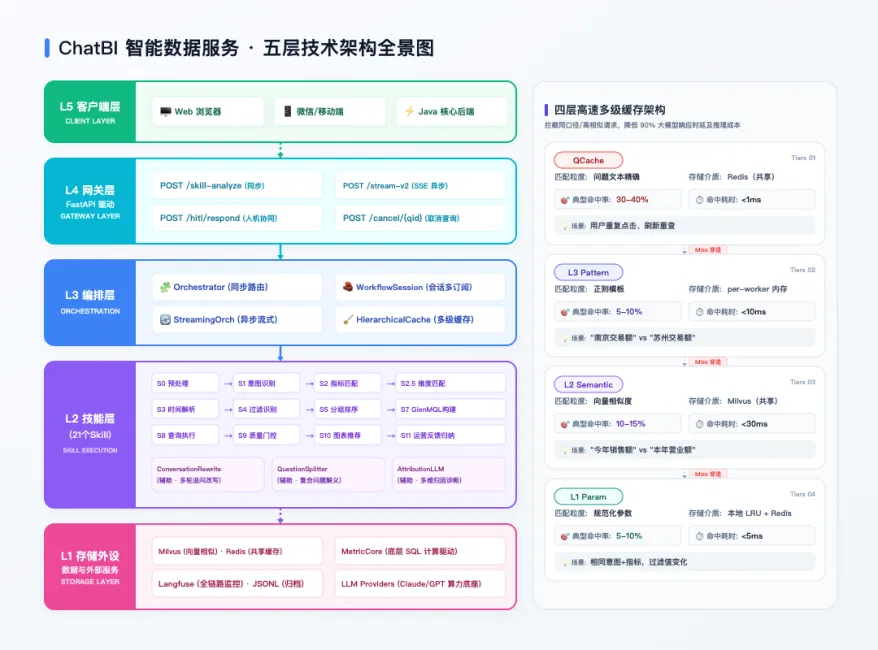
亮眼表现的背后,是源启ChatBI从底层逻辑出发的原生架构设计,直击传统AI问数的核心短板:
1. Skill Pipeline流水线架构
摒弃依赖大模型自由推理、反复试错的传统模式。将数据分析拆解为职责清晰的标准化技能模块,以确定性流水线完成全流程分析。流程可预测、模块可测试、问题可快速定位修复,从根源上解决了传统方案稳定性差、调试难、成本高的问题。
2. 对话理解层(槽位体系)
搭建覆盖16类维度的槽位识别体系,自动完成意图识别、指标维度提取、条件完备性校验,精准拆解用户自然语言诉求。针对多轮对话设计了新旧意图隔离策略,避免不同分析任务的上下文互相干扰;面对包含多子任务的复合问句,可自动拆分分步执行,聚合最终结果。
3. 企业级业务语义层
听懂语言只是基础,对齐企业数据标准才是落地关键。源启ChatBI内置8类语义资产管理能力,统一指标、维度、枚举值的业务口径,自动匹配企业内部数据规范;遇到多口径歧义时主动澄清,杜绝模型自行猜测导致的口径偏差。
4. 四层分级缓存机制
构建从查询原文、句式模式、语义任务到参数模板的四层缓存体系,完全一致的提问、同类业务分析需求均可复用历史运算结果,日常高频业务查询直接命中缓存,全程无需调用大模型,持续压缩使用成本。
5. HITL 人机协同校验
坚守“存疑必问、绝不盲答”的企业级原则。当系统识别到指标多口径、维度多匹配等歧义场景时,自动弹出确认选项,由业务人员选定标准后再执行分析,用一次简单交互规避数据错误带来的决策风险。
6. 自动化自进化闭环
搭建用户反馈自动化迭代链路,业务人员标注的问题案例自动沉淀至语义资产库,高频错误触发规则优化;每日自动执行批量回归测试,迭代过程全程可回滚,长期使用中产品识别准确率能够稳步自主提升。
下一代企业数据竞争的核心,早已不是谁拥有更多数据,而是谁能让更多人用好数据。中电金信源启ChatBI以企业级的稳定性、可控的成本、极低的使用门槛,将专业数据分析能力下沉为全员可用的基础能力,助力企业真正实现数据驱动业务增长。